Ein Handwerksmeister fragt ChatGPT nach seinem eigenen Betrieb und bekommt nichts. Solche Fälle sehen wir regelmäßig. Oft liegt es gar nicht an den Texten, sondern an einem Sicherheits-Plugin, in dem irgendwann jemand „alle KI-Bots blockieren“ angehakt hat.
Dabei klopfen längst nicht mehr nur Google und Bing an, sondern täglich auch Bots von OpenAI, Anthropic, Perplexity und Apple. Mit der robots.txt steuerst du diese KI-Crawler einzeln. Die Frage ist nur, welchen du aussperren kannst, ohne dir selbst die Sichtbarkeit in KI-Antworten zu nehmen. Das gehen wir Bot für Bot durch, mit fertiger Beispiel-Datei und einem ehrlichen Blick auf llms.txt.
Kurz gesagt: KI-Crawler lassen sich in drei Gruppen teilen: Trainings-Bots (z. B. GPTBot, ClaudeBot, CCBot), Such-Bots (OAI-SearchBot, Claude-SearchBot, PerplexityBot) und Nutzer-Abrufe (ChatGPT-User, Claude-User, Perplexity-User). Wer in ChatGPT, Claude oder Perplexity als Quelle auftauchen will, sollte die Such-Bots erlauben. Das Training ist eine eigene Entscheidung und lässt sich getrennt sperren. Google-Extended steuert nur das Gemini-Training, nicht die AI Overviews. llms.txt ist ein Vorschlag, den bisher kein großer Anbieter offiziell nutzt.
Was sind KI-Crawler überhaupt?
Ein KI-Crawler ist ein automatisiertes Programm, das Webseiten abruft, um deren Inhalte für ein KI-System nutzbar zu machen. Technisch ähnelt er dem Googlebot und nennt sich im sogenannten User-Agent beim Namen. Anders ist der Zweck.
Bei Google war die Rechnung einfach. Google crawlt, du bekommst Besucher. Bei KI-Systemen hängt der Gegenwert davon ab, welcher Bot vor der Tür steht. Ein Plugin, das pauschal alles sperrt, wirft deshalb auch die nützlichen mit raus.
Training, Suche, Nutzer-Abruf: drei Arten von KI-Bots
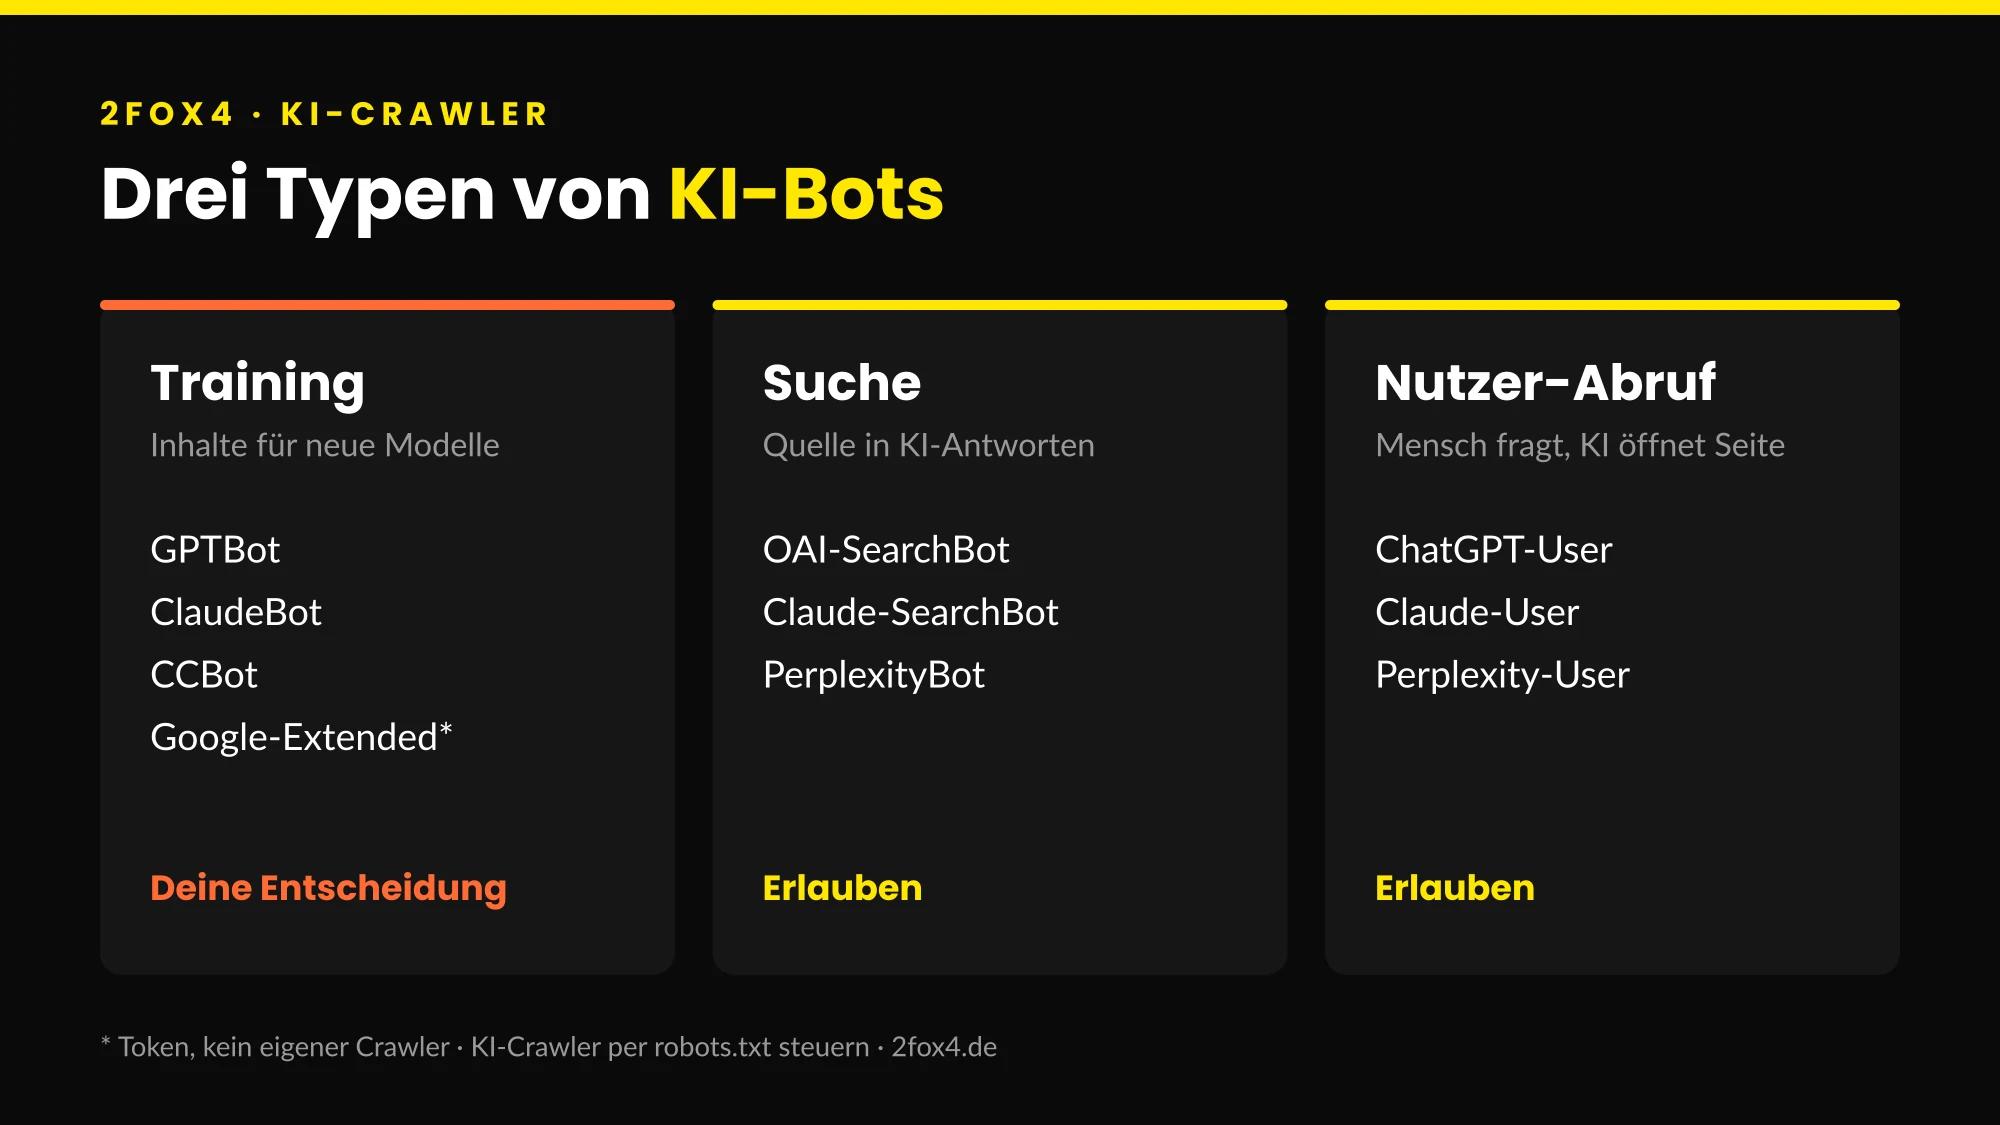
Trainings-Crawler sammeln öffentlich zugängliche Inhalte, die in das Training künftiger Sprachmodelle einfließen können. Einen direkten Gegenwert bekommst du dafür nicht. Sperrst du sie, landet dein Inhalt nicht mehr in neuen Trainingsdaten. Ob ChatGPT dich heute zitiert, hängt davon nicht direkt ab.
Such-Crawler bauen einen Index auf, aus dem die KI bei einer Suchanfrage passende Quellen zieht. Sie arbeiten wie ein klassischer Suchmaschinen-Bot, nur steht am Ende eine Antwort mit Quellenlinks. Sperrst du sie, fällt deine Website aus diesen Antworten weitgehend heraus.
Nutzer-Abrufe sind keine Crawler im eigentlichen Sinn. Sie werden aktiv, wenn jemand im Chat eine URL einfügt oder die KI im Gespräch eine Seite öffnen soll. Weil ein Mensch den Abruf auslöst, behandeln mehrere Anbieter diese Zugriffe anders als automatisches Crawling.
Welche KI-Crawler gibt es? Die wichtigsten Bots
OpenAI: GPTBot, OAI-SearchBot und ChatGPT-User
OpenAI trennt seine Bots nach Zweck und dokumentiert das in der offiziellen Übersicht der OpenAI-Crawler.
- GPTBot crawlt Inhalte, die für das Training der generativen Basismodelle genutzt werden können. Wer GPTBot per robots.txt sperrt, signalisiert laut OpenAI, dass die Inhalte nicht für das Training verwendet werden sollen.
- OAI-SearchBot sorgt dafür, dass Websites in den Suchfunktionen von ChatGPT erscheinen. Seiten, die diesen Bot aussperren, tauchen in den Suchantworten nicht auf, können aber weiterhin als reiner Navigationslink erscheinen.
- ChatGPT-User ist für Aktionen zuständig, die ein Nutzer in ChatGPT oder in einem Custom GPT auslöst. Laut OpenAI crawlt dieser Agent nicht automatisch durchs Web, und robots.txt-Regeln greifen hier unter Umständen nicht, weil ein Mensch den Abruf veranlasst hat. Mit der Aufnahme in die Suche hat er nichts zu tun.
Laut OpenAI sind die Einstellungen unabhängig voneinander. Du kannst also OAI-SearchBot erlauben und GPTBot sperren. Dann bist du in ChatGPT sichtbar, aber nicht im Training.
Anthropic: ClaudeBot, Claude-SearchBot und Claude-User
Anthropic folgt demselben Prinzip und erklärt die drei Bots in einem Hilfeartikel zum Crawling von Anthropic.
- ClaudeBot sammelt Webinhalte, die zum Training der Modelle beitragen können. Eine Sperre schließt künftige Inhalte aus den Trainingsdaten aus.
- Claude-SearchBot indexiert Inhalte, um die Suchergebnisse für Claude-Nutzer zu verbessern. Wer ihn sperrt, riskiert laut Anthropic, dass die eigenen Inhalte in den Suchantworten seltener oder ungenauer auftauchen.
- Claude-User ruft Seiten ab, wenn ein Claude-Nutzer eine Frage stellt, für die eine bestimmte Seite nötig ist. Ist dieser Bot gesperrt, kann Claude deine Inhalte für solche Anfragen nicht mehr abrufen.
Anthropic gibt an, die robots.txt zu beachten, und unterstützt zusätzlich die nicht standardisierte Anweisung Crawl-delay. Damit drosselst du bei Bedarf die Abrufrate.
Perplexity: PerplexityBot und Perplexity-User
Perplexity beschreibt seine Bots in der Perplexity-Dokumentation zu Crawlern. PerplexityBot zeigt und verlinkt Websites in den Suchergebnissen von Perplexity. Für das Training von KI-Basismodellen setzt Perplexity ihn laut eigener Aussage nicht ein, einen reinen Trainings-Bot gibt es dort also nicht.
Perplexity-User unterstützt Aktionen innerhalb von Perplexity, etwa wenn die KI für eine Nutzerfrage eine Seite besucht und sie in der Antwort verlinkt. Perplexity schreibt offen, dass dieser Abruf robots.txt-Regeln in der Regel ignoriert, weil ein Nutzer ihn angefordert hat. Wer ihn wirklich draußen haben will, muss auf Server- oder Firewall-Ebene ran.
Google-Extended: ein Steuer-Token, kein eigener Crawler
Bei Google wird es verwirrend. Google-Extended ist laut Googles Übersicht der Crawler ein eigenständiges Produkt-Token für die robots.txt. In deinen Logs wirst du keinen Bot mit diesem Namen finden. Es sagt Google nur, ob die gecrawlten Inhalte für das Training künftiger Gemini-Modelle und für das Grounding in Produkten wie den Gemini Apps oder der Vertex AI API genutzt werden dürfen.
Google schreibt ausdrücklich, dass Google-Extended weder die Aufnahme in die Google-Suche beeinflusst noch ein Ranking-Signal ist. Auch die AI Overviews und den KI-Modus der Google-Suche steuerst du damit nicht. Die laufen über den normalen Googlebot. Wer dort Inhalte begrenzen will, muss laut Google zu den bekannten Snippet-Steuerungen greifen, also nosnippet, data-nosnippet, max-snippet oder noindex, und verliert damit auch Sichtbarkeit in der normalen Suche.
Applebot-Extended, CCBot und Bytespider
Applebot-Extended funktioniert wie Google-Extended. Laut Apples Seite zum Applebot crawlt er selbst nichts, sondern legt nur fest, ob die vom normalen Applebot gesammelten Daten zum Training von Apples Basismodellen verwendet werden dürfen, die etwa Apple Intelligence antreiben. Auf Apples Suchergebnisse und das Ranking hat die Sperre keinen Einfluss.
CCBot gehört zu Common Crawl, einer gemeinnützigen Organisation, die eine Kopie des öffentlichen Webs kostenlos zum Download bereitstellt. Der Bot beachtet laut Common Crawl die robots.txt einschließlich Crawl-delay. Wer den frei verfügbaren Datensatz später weiterverarbeitet, hast du nicht mehr in der Hand. Willst du grundsätzlich kein Training, gehört CCBot deshalb mit auf die Sperrliste.
Bytespider ist der Crawler von ByteDance, dem Konzern hinter TikTok. Cloudflare hat ihn 2024 als den KI-Crawler mit den meisten Anfragen in seinem Netzwerk ausgewiesen. Eine offizielle Dokumentation zu Zweck und Regeln gibt es nicht. Wir sperren ihn und blockieren ihn im Zweifel zusätzlich per Firewall.
Tabelle: KI-Bots, ihr Zweck und unsere Empfehlung für KMU
| Bot (User-Agent) | Anbieter | Zweck | Folgt robots.txt? | Empfehlung für die meisten KMU |
|---|---|---|---|---|
| GPTBot | OpenAI | Training | ja | optional, eigene Entscheidung |
| OAI-SearchBot | OpenAI | Suche in ChatGPT | ja | erlauben |
| ChatGPT-User | OpenAI | Nutzer-Abruf | nicht unbedingt | erlauben |
| ClaudeBot | Anthropic | Training | ja | optional, eigene Entscheidung |
| Claude-SearchBot | Anthropic | Suche in Claude | ja | erlauben |
| Claude-User | Anthropic | Nutzer-Abruf | ja | erlauben |
| PerplexityBot | Perplexity | Suche | ja | erlauben |
| Perplexity-User | Perplexity | Nutzer-Abruf | in der Regel nein | erlauben |
| Google-Extended | Token für Gemini-Training und Grounding | ja (nur Token) | optional | |
| Applebot-Extended | Apple | Token für Apple-Modelltraining | ja (nur Token) | optional |
| CCBot | Common Crawl | offener Web-Datensatz | ja | sperren, wenn kein Training gewünscht |
| Bytespider | ByteDance | nicht offiziell dokumentiert | unklar | sperren |
Die Spalte „Folgt robots.txt?" gibt wieder, was die Anbieter selbst schreiben. Mehr als eine höfliche Bitte ist die robots.txt nie.
Sichtbar werden oder Inhalte schützen? So entscheidest du
Die meisten Betriebe wollen in KI-Antworten auftauchen. Der Elektriker möchte genannt werden, wenn jemand ChatGPT nach einem Fachbetrieb für Wallboxen fragt. Das Steuerbüro freut sich, wenn Perplexity seinen Ratgeber zur Grundsteuer verlinkt. Für beide ist die Sache klar. Such-Bots und Nutzer-Abrufe bleiben offen. Wie du prüfst, ob das schon klappt, zeigen wir im Beitrag Sichtbarkeit in KI-Suchmaschinen messen.
Beim Training ist es weniger eindeutig. Hier gibt es zwei vernünftige Haltungen.
Training erlauben ist sinnvoll, wenn deine Inhalte vor allem Werbung für dich sind: Leistungsseiten, Referenzen, allgemeine Ratgeber. Dass ein Modell deine Firma dann „kennt", kann langfristig helfen, belegt ist das aber kaum.
Training sperren ist sinnvoll, wenn deine Inhalte selbst das Produkt sind. Ein Fachverlag, ein Online-Kurs oder ein Shop mit aufwendig geschriebenen Produkttexten hat gute Gründe, nicht alles kostenlos in Trainingsdaten zu geben.
„Komplett offen“ oder „komplett zu“ sind also nicht die einzigen Optionen. Bei OpenAI und Anthropic ist die Trennung zwischen Training und Suche offiziell dokumentiert, und genau die nutzt das folgende Beispiel.
Beispiel: Eine robots.txt für KI-Crawler
Die robots.txt liegt immer im Hauptverzeichnis deiner Domain, also unter https://www.deine-domain.de/robots.txt. Das Beispiel zeigt den häufigsten Fall, nämlich in KI-Suchen sichtbar bleiben und das Training sperren. Der erste Block erlaubt KI-Suche und Nutzer-Abrufe, der zweite sperrt das Training, der dritte regelt alle übrigen Bots, also auch Googlebot und Bingbot.
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Bytespider
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.deine-domain.de/sitemap.xml
Damit nichts schiefgeht, noch ein paar Hinweise:
- Mehrere User-agent-Zeilen hintereinander teilen sich einen Regelblock.
- Ein Bot liest nur seinen spezifischsten Block. Hat OAI-SearchBot einen eigenen Block, ignoriert er die Regeln unter
User-agent: *. Deshalb taucht die Sperre für/wp-admin/im Beispiel zweimal auf. Alles, was nicht ausdrücklich gesperrt ist, darf gecrawlt werden. - Willst du Training erlauben, löschst du die betreffenden Zeilen im Sperr-Block.
- Nur Teile sperren geht auch, etwa einen Mitgliederbereich:
Disallow: /intern/im jeweiligen Block.
Bei WordPress erzeugen übrigens SEO-Plugins wie Rank Math oder Yoast eine virtuelle robots.txt, die du im Plugin bearbeitest. Liegt zusätzlich eine echte Datei auf dem Server, gewinnt in der Regel diese. Wie du WordPress-Websites allgemein fit für ChatGPT machst, steht in unserem Beitrag WordPress und ChatGPT-Sichtbarkeit.
Cloudflare und Firewalls: die Sperre, die keiner sieht
Jetzt kommt die häufigste Falle. Deine robots.txt kann noch so sauber sein. Sitzt davor eine Firewall oder ein CDN, das KI-Bots blockiert, kommt trotzdem keiner durch.
Cloudflare hat am 1. Juli 2025 seine Standardeinstellung geändert. Seitdem werden Inhaber neuer Domains bei der Einrichtung gefragt, ob sie KI-Crawler zulassen wollen, und das Blockieren ist voreingestellt. Gleichzeitig kam „Pay per Crawl", mit dem Website-Betreiber KI-Crawlern den Zugriff in Rechnung stellen können. Das berichteten unter anderem CNBC und Cloudflare selbst. Einen Schalter, mit dem auch Nutzer des kostenlosen Tarifs KI-Bots per Klick blockieren können, gibt es schon seit 2024.
Läuft deine Website über Cloudflare, schau deshalb im Dashboard nach. Unter AI Crawl Control findest du eine Liste der erkannten KI-Crawler und kannst für jeden einzeln „Allow" oder „Block" wählen. Sind dort Such-Bots wie OAI-SearchBot oder PerplexityBot geblockt, nützt die schönste robots.txt nichts. Cloudflare bietet außerdem eine verwaltete robots.txt an, die Regeln für KI-Crawler automatisch ergänzt. Wenn du sie nutzt, schau dir an, was danach wirklich in deiner Datei steht.
Ähnlich ist es bei Sicherheits-Plugins in WordPress, beim Bot-Schutz mancher Hoster und bei Webanwendungs-Firewalls. Viele haben inzwischen eigene Schalter für KI-Bots. Ob irgendwo etwas blockiert, verraten dir am Ende nur die Logs.
Server-Logs prüfen: Wer kommt wirklich vorbei?
Die robots.txt sagt nur, was du dir wünschst. Was tatsächlich passiert, steht in den Zugriffsprotokollen deines Servers, den Access-Logs. Die findest du bei den meisten Hostern im Kundenmenü. So gehst du vor:
- Logs herunterladen. Ein bis zwei Wochen reichen für einen ersten Eindruck.
- Nach User-Agents suchen. Eine Suche nach „GPTBot", „OAI-SearchBot", „ClaudeBot", „PerplexityBot" oder „Bytespider" zeigt dir, wer kommt.
- Statuscodes ansehen. Ein
200bedeutet, der Bot hat die Seite bekommen. Ein403heißt, irgendetwas blockiert ihn, oft die Firewall. - Abrufe der robots.txt prüfen. Seriöse Crawler holen sich zuerst diese Datei. Taucht ein Bot auf, der das nie tut und gesperrte Bereiche trotzdem abruft, ist das ein Fall für die Firewall.
Ein Haken bleibt. Der User-Agent lässt sich fälschen, jeder kann seinem Skript den Namen „GPTBot" geben. Mehrere Anbieter veröffentlichen deshalb die IP-Adressbereiche ihrer Bots, mit denen du verdächtige Zugriffe abgleichen kannst.
Was ist llms.txt, und brauchst du die Datei?
llms.txt ist ein Vorschlag für eine Markdown-Datei im Stammverzeichnis einer Website, die KI-Systemen eine kompakte, kuratierte Übersicht über die wichtigsten Inhalte gibt. Die Idee wurde im September 2024 auf llmstxt.org veröffentlicht. Sie besteht aus einer Überschrift mit dem Namen der Website, einer kurzen Zusammenfassung als Zitatblock und Abschnitten mit Linklisten.
Für Software-Dokumentationen ist das durchaus sinnvoll. Schaut man aber, wer die Datei tatsächlich nutzt, wird es dünn:
- Googles Gary Illyes sagte im Juli 2025 auf einer Search-Central-Veranstaltung, dass Google llms.txt nicht unterstützt und das auch nicht plant. So berichtete es Search Engine Land.
- Im Mai 2026 hat Google einen offiziellen Leitfaden zur Optimierung für generative KI-Funktionen in der Suche veröffentlicht. Darin steht, dass du weder llms.txt noch spezielle Markdown-Versionen deiner Seiten brauchst, um in diesen Funktionen zu erscheinen. Findet der Crawler eine solche Datei, behandelt Google sie wie jede andere Textdatei.
- Etwa zur selben Zeit kam Lighthouse 13.3 mit einer neuen Kategorie für Browser-Agenten, die unter anderem prüft, ob eine llms.txt vorhanden ist. Die Kategorie ist noch in Entwicklung und hat laut Search Engine Journal nichts mit Rankings zu tun.
- Einzelne Website-Betreiber berichten aus ihren Logs, dass OpenAI-Crawler die Datei abrufen. Ausgewertet ist sie damit noch nicht.
Unterm Strich hat bis heute kein großer KI-Anbieter offiziell bestätigt, dass seine Such- oder Antwortsysteme llms.txt auswerten. Wir halten die Datei deshalb für optional.
Lohnt sich der Aufwand?
Eine einfache llms.txt für eine typische KMU-Website ist schnell erstellt. Sie schadet nicht, und setzt sich der Standard doch durch, bist du vorbereitet. Markdown-Versionen jeder einzelnen Seite zu pflegen, ist dagegen viel Arbeit für einen unklaren Ertrag.
Für die Sichtbarkeit in KI-Antworten bringt mehr, was auch bei Google zählt. Gut gegliederte Seiten, klare Aussagen, saubere strukturierte Daten und Inhalte, die eine Frage wirklich beantworten. Wie du eine Website so aufbaust, dass auch KI-Agenten sie zuverlässig lesen und nutzen können, beschreiben wir im Beitrag über KI-Agenten als Käufer und maschinenlesbare Websites.
Vier Fehler, die wir bei KI-Bots immer wieder sehen
Alles pauschal sperren. Wer User-agent: * mit Disallow: / kombiniert oder ein Plugin „alle Bots blockieren" lässt, sperrt im schlimmsten Fall auch Google aus. Das passiert gern nach einem Relaunch, wenn die Sperre der Testumgebung einfach mit live geht.
Die falschen Bots verwechseln. Wer nur GPTBot sperrt, bleibt in der ChatGPT-Suche sichtbar. Wer Google-Extended sperrt, bleibt in den AI Overviews. Beides ist in Ordnung, solange du es so willst.
Tippfehler im User-Agent. Groß- und Kleinschreibung spielt beim Namen in der Regel keine Rolle, ein falscher Bindestrich wie bei „Perplexity-Bot" aber schon: Die Regel läuft dann ins Leere. Kopiere die Namen immer aus der offiziellen Doku.
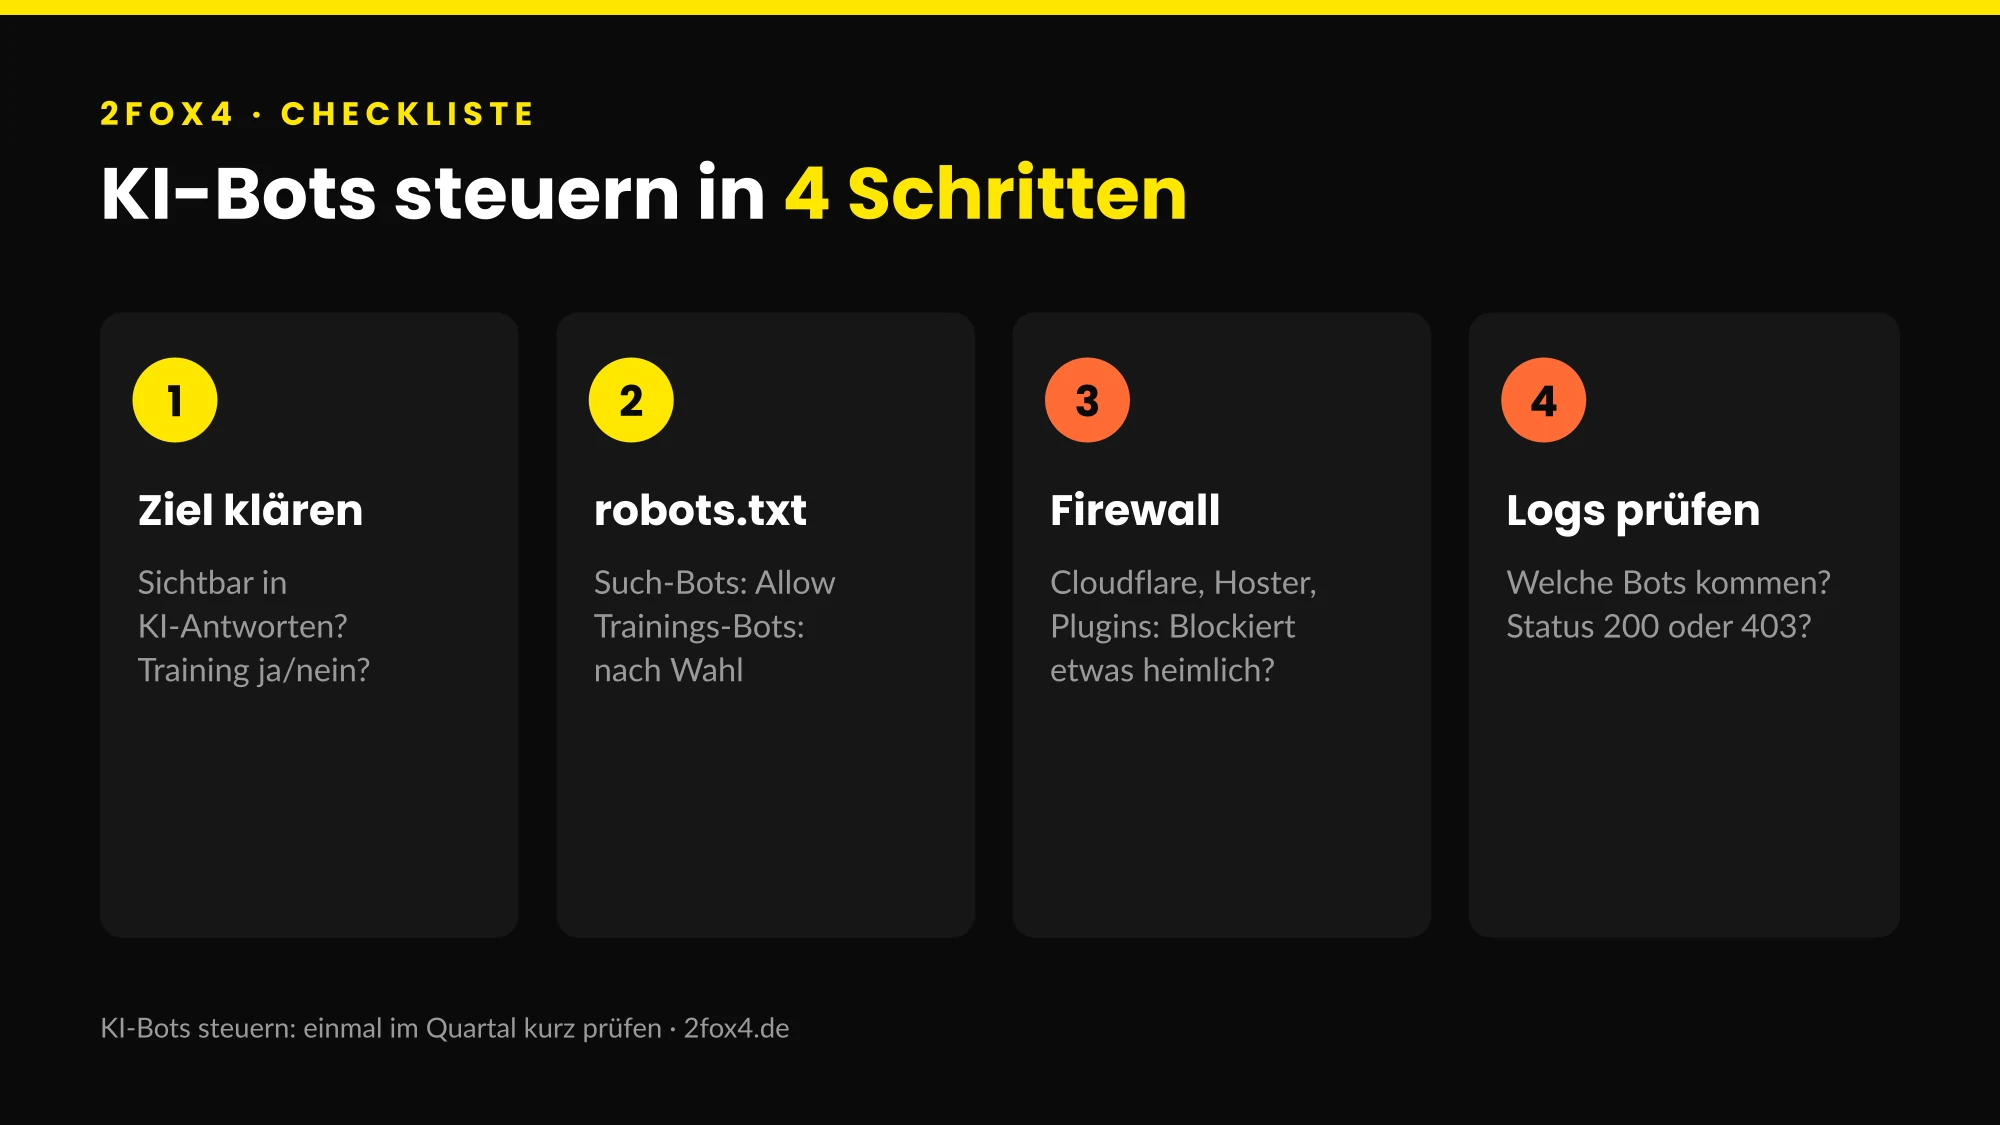
Einmal einstellen und nie wieder anschauen. Neue Bots kommen dazu, alte werden umbenannt. Einmal im Quartal kurz draufschauen reicht meistens.
Fazit: Suche offen lassen, Training getrennt entscheiden
KI-Crawler per robots.txt zu steuern, ist technisch schnell erledigt. Schwieriger ist die Haltung dahinter. Für die meisten KMU heißt sie, Such-Bots und Nutzer-Abrufe zu erlauben. Ob deine Texte zusätzlich ins Training neuer Modelle fließen, entscheidest du getrennt, je nachdem, wie viel Wert in den Inhalten selbst steckt. Und dann schaust du nach, ob Cloudflare, Hoster oder ein Plugin deine Datei nicht heimlich überstimmen.
llms.txt kannst du anlegen, musst du aber nicht. Wenn wir im Rahmen unserer SEO-Betreuung eine Website prüfen, schauen wir uns robots.txt, Bot-Einstellungen und Logs gemeinsam an und arbeiten dann an Inhalten, die in Google und in KI-Antworten als Quelle taugen. Du weißt nicht genau, was bei dir gerade eingestellt ist? Dann melde dich gern bei uns.
Häufige Fragen (FAQ)
Sollte man GPTBot blockieren?
Das hängt davon ab, ob deine Inhalte für das Training von OpenAI-Modellen genutzt werden dürfen. Eine Sperre von GPTBot betrifft laut OpenAI nur das Training. Deine Sichtbarkeit in der ChatGPT-Suche steuert der separate OAI-SearchBot. Für die meisten KMU ist es sinnvoll, OAI-SearchBot zu erlauben und über GPTBot bewusst zu entscheiden.
Verschwindet eine Website aus den Google AI Overviews, wenn sie Google-Extended sperrt?
Nein. Google-Extended steuert nur, ob Inhalte für das Training von Gemini-Modellen und für das Grounding in Produkten wie den Gemini Apps genutzt werden. Die AI Overviews und der KI-Modus der Google-Suche laufen über den normalen Googlebot und lassen sich nur mit Snippet-Steuerungen wie nosnippet oder noindex begrenzen.
Halten sich alle KI-Crawler an die robots.txt?
Nicht zuverlässig. OpenAI, Anthropic, Google, Apple und Common Crawl geben an, die robots.txt für ihre Crawler zu beachten. Nutzer-Abrufe wie ChatGPT-User oder Perplexity-User berücksichtigen sie laut den Anbietern aber nicht in jedem Fall. Wer einen Bot wirklich aussperren will, braucht zusätzlich eine Firewall-Regel, etwa über Cloudflare.
Was ist llms.txt und bringt die Datei etwas für SEO?
llms.txt ist ein 2024 veröffentlichter Vorschlag für eine Markdown-Datei, die KI-Systemen eine kuratierte Übersicht über die wichtigsten Inhalte einer Website gibt. Google behandelt sie laut eigenem Leitfaden wie eine gewöhnliche Textdatei, und kein großer KI-Anbieter hat bisher offiziell bestätigt, sie auszuwerten. Sie schadet nicht, ist aber kein wirksamer SEO-Hebel.
Wie findest du heraus, ob Cloudflare KI-Bots auf deiner Website blockiert?
Im Cloudflare-Dashboard findest du unter AI Crawl Control eine Liste der erkannten KI-Crawler mit dem Status Allow oder Block. Für neue Domains ist das Blockieren von KI-Crawlern inzwischen voreingestellt. Prüfe zusätzlich in den Server-Logs, ob Such-Bots wie OAI-SearchBot den Statuscode 200 oder 403 erhalten.
Wie lange dauert es, bis eine Änderung der robots.txt wirkt?
Das ist je nach Anbieter verschieden. OpenAI nennt für die Suchfunktionen von ChatGPT rund 24 Stunden, bis eine Änderung berücksichtigt wird. Andere Anbieter machen keine genauen Angaben. Rechne außerdem damit, dass eine Sperre nur für künftige Abrufe gilt: Anthropic etwa spricht ausdrücklich davon, künftige Inhalte aus den Trainingsdaten auszuschließen.